import asyncio

import IPython.display as ipy
import openai as oai
import torch
import vllm

print('PyTorch version:', torch.__version__)
print('vLLM version:', vllm.__version__)18.1 从 generate() 到 vLLM:为什么推理需要一个 Engine

前面介绍 LLM inference 时,我们已经讨论了 prefill、decode、KV cache、continuous batching,以及如何通过 API 把模型部署成服务。从原理上看,我们已经知道,一个推理引擎需要管理多个请求,并且在每一轮计算中决定哪些 token 应该进入 GPU。
但这些概念还没有回答一个工程问题:
当多个用户同时发送请求时,谁来接收请求、安排计算、管理显存,并把结果送回各自的用户?
如果只看 model.generate(),我们很难看到这些工作。因为 generate() 的主要接口是给定输入、执行生成、返回结果。至于什么时候接收新请求、怎么在请求之间分配 GPU 时间、哪些 KV cache 可以复用,这些并不是一个普通生成调用本身就能完整解决的问题。
vLLM (Kwon et al. 2023) 就是为这些问题设计的推理引擎。这一章不再重复推理算法的基本原理,而是以 vLLM V1 为主线,沿着真实的请求执行路径,把 Scheduler、KVCacheManager、PagedAttention、Model Runner 等组件联系起来。
PyTorch version: 2.13.0+cu132
vLLM version: 0.30.0
model = 'Qwen/Qwen3-0.6B'
llm = vllm.LLM(model, max_model_len=2048)
ipy.clear_output()
print('Model:', llm.model_config.model)Model: Qwen/Qwen3-0.6B18.1.1 从一个生成函数到一个长期运行的 Engine
先考虑我们熟悉的单次推理:
output = model.generate(input_ids, max_new_tokens=64)这里的重点是完成一次生成任务。但在服务场景中,请求不是提前全部准备好的。假设我们有三个用户。A 发送了 1000 个 prompt token,B 发送了 20 个 prompt token,C 在 A 已经开始生成后才发来请求。引擎需要在处理 A 的同时接收 B 和 C,并在 GPU 资源、KV cache 空间和调度策略的限制下安排计算。
这意味着,推理服务不能只有 forward() 和 sample(),还需要维护一个不断变化的请求集合:
- 新请求可能随时到达,而已经进入 GPU 的请求可能尚未完成;
- 不同请求已经计算的 token 数量不同,需要保留各自的进度;
- KV cache 占用会随着生成变化,请求完成或取消后还需要释放资源;
- 本轮 GPU 执行结束后,某些请求会产生输出,另一些请求可能还在等待。
这里要区分两件事:模型计算负责根据输入得到新 token,而 Engine 负责让许多独立的生成任务共享计算资源,并持续推进它们的状态。Hugging Face generate() 也支持批量输入和一定程度的生成控制,因此两者的区别是,有没有一套面向动态请求的调度与资源管理机制。
所以,我们可以把 vLLM 的核心工作概括为一个不断重复的过程:
- 接收新请求;
- 决定本轮计算哪些请求、每个请求计算多少 token;
- 执行模型,得到新 token;
- 更新请求状态,检查是否完成或需要继续生成;
- 返回输出给客户端。
18.1.2 Offline Inference 和 Online Serving
vLLM 提供两种常见的使用方式。第一种是 offline inference,我们在 Python 中直接创建 LLM,一次传入多个 prompt;第二种是 online serving,启动一个长期运行的 HTTP server,由外部客户端发送请求。
例如,offline inference 可以直接使用 LLM.chat():
conversations = [
    [{'role': 'user', 'content': 'Explain Minecraft in one sentence.'}],
    [{'role': 'user', 'content': 'Give me one reason to play Minecraft.'}],
]

outputs = llm.chat(
    messages=conversations,
    sampling_params=vllm.SamplingParams(temperature=0.7, max_tokens=64),
    chat_template_kwargs={'enable_thinking': False},
    use_tqdm=False,
)

for i, output in enumerate(outputs, start=1):
    print(f'Response {i}:', output.outputs[0].text, '\n')
Response 1: Minecraft is a sandbox game where players create, develop, and explore an imaginary world constructed from blocks.
Response 2: One reason to play Minecraft is to create and explore imaginative worlds, which can be both fun and educational.这里我们特意使用 chat() 而不是直接把对话文本传给 generate(),因为 chat() 会根据模型的 chat template 整理消息,提高输出质量。对于 Qwen3,我们还通过 enable_thinking=False 关闭 thinking 模式,以便观察较短的普通回答。这些参数影响的是输入格式和生成行为,而不是 vLLM Engine 的整体结构。
Online serving 则通过 vllm serve 启动长期运行的服务。启动后,外部程序通过 HTTP 发送 chat completion 请求,不再直接操作 LLM 对象。完整的命令和客户端代码会放在本节后面的实验里,方便我们对照架构观察实际执行路径。
虽然入口不同,但两者在处理请求时最终都需要依赖 vLLM 的核心引擎。可以用下面这张图理解:
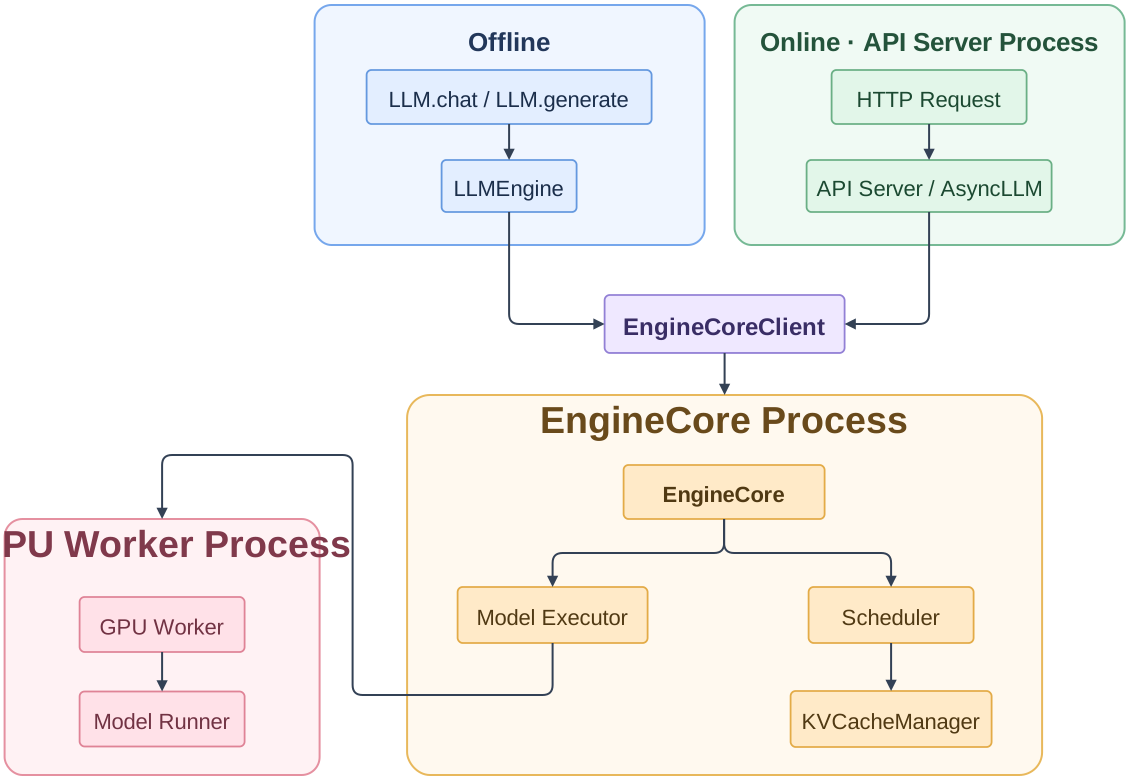
这是一张逻辑组件图,不是严格的数据流图。不同入口和执行后端可能采用不同的进程组织方式,图中的箭头也省略了输入、输出处理的部分细节。每个组件具体的作用,我们会在后面逐渐展开。这里的重点是,无论是 offline 还是 online,最终都要经过同一套底层的调度和执行机制。
18.1.3 vLLM V1 的整体架构
vLLM V1 最值得先理解的一点,是它把请求入口、调度控制和 GPU 执行分成了不同的职责。对于常见的 online serving + GPU 多进程部署,可以把系统划分成三层。
第一层是 API Server。它面向用户,负责处理 HTTP 请求、组织输入消息、进行必要的分词或多模态输入处理,并把引擎返回的生成结果转成 API response。客户端不需要知道 GPU 上正在执行多少个请求,也不需要直接管理 KV cache。
第二层是 EngineCore。它负责持续推进推理任务。EngineCore 持有 Scheduler、KVCacheManager 等核心状态,决定这一轮要处理哪些请求、处理多少 token,以及何时释放已完成请求的资源。注意,EngineCore 并不是 Transformer 模型本身,也不是一个只负责转发数据的简单队列。
第三层是 GPU Worker。真正的模型权重加载、GPU buffer 管理和 model forward 在 GPU worker 一侧进行。Worker 通过 Model Runner 准备计算所需的输入和 attention metadata,再调用模型执行。对于多 GPU 部署,Model Executor 还需要协调各个 worker。

在常见的 online serving 架构下,API server 与 EngineCore 通过进程间通信(例如 ZMQ)交换数据,GPU worker 也通常位于独立进程。多 GPU、多实例或者特定执行后端可能改变进程数量与通信方式。
为什么需要这样的分层?因为三个部分的工作性质不同。API server 主要处理请求和数据格式,Scheduler 主要操作 CPU 上的请求状态与缓存元信息,而 GPU worker 负责实际的计算与显存访问。将它们解耦以后,GPU 在执行模型时,前端仍然可以接收和处理其他请求,EngineCore 也可以集中维护调度状态。
这并不意味着 CPU 调度和 GPU 计算总能完全重叠,也不代表进程越多越快。进程之间需要通信,同步与序列化同样有开销。V1 的设计目标是减少这些额外成本,同时让核心推理路径更清晰。
18.1.4 EngineCore 每一轮到底做什么
我们先不深入源码,而是关注 EngineCore 的核心职责。在最简化的执行路径中,一轮计算可以写成:
EngineCore.step()
    │
    ├── Scheduler.schedule()
    │
    ├── ModelExecutor.execute_model()
    │
    └── Scheduler.update_from_output()
这里有三个重要的中间结果。
首先,schedule() 描述的是本轮需要执行什么。例如,哪些请求会参与执行、每个请求分配多少计算 token,以及它们所需的缓存信息。注意,Scheduler 不直接生成 token,它只是制定本轮的执行计划。
接着,execute_model() 才是真正执行。Model Executor 将工作分发到 worker,由 Model Runner 完成输入准备、模型计算和必要的采样流程。不同模型和配置可能采用不同的执行路径,但这些差异不会改变 Scheduler 与模型执行之间的基本分工。
最后,update_from_output() 根据执行结果更新请求的进度,检查是否需要继续生成、是否已经达到停止条件,以及哪些结果应该返回客户端。没有完成的请求会留在系统中,等待后面的调度轮次。
在实际的 V1 源码里,EngineCore 还涉及异步执行、batch queue、请求取消、调度暂停、错误处理等逻辑,因此上面的三行不能替代完整的 EngineCore.step() 实现。不过,它准确表达了我们后面分析核心执行路径时需要追踪的三个阶段:
Schedule -> Execute -> Update。
18.1.5 一个 Request 从进入到结束经历什么
现在假设客户端发送一条消息:
{
  "model": "Qwen/Qwen3-0.6B",
  "messages": [
    {
      "role": "user",
      "content": "What should I build first in Minecraft survival mode?"
    }
  ],
  "temperature": 0.7,
  "max_tokens": 128
}
在典型的 online serving 路径中,这个请求大致经历以下过程:
- 接收请求。API server 校验输入参数,按模型的 chat template 组织对话,并完成必要的输入处理。
- 创建引擎请求。前端会为请求准备 token IDs、sampling parameters 以及其他相关的 matadata,通过 EngineCoreClient 发送到 EngineCore。
- 进入调度系统。Scheduler 记录新请求,等待合适的执行机会,并根据需要查询或分配 KV cache。
- 执行本轮计算。Scheduler 产生本轮执行计划,EngineCore 通过 Model Executor 调用 GPU worker。
- 更新请求状态。Model Runner 返回计算结果后,Scheduler 更新请求进度。尚未完成的请求会继续参与后续调度。
- 输出与结束。返回的 token 经输出处理、detokenization 等环节转换为 API 数据。当请求完成或被取消时,引擎清理相关状态和资源。
这条路径里,有两点容易被忽略。
第一,一个请求不等于一次 GPU forward。对于自回归生成,同一请求通常需要参与多轮执行,而不同请求可以共享同一轮 GPU 计算。也就是说,HTTP request、Engine 内部 request 和某一轮 GPU batch 并不是同一个概念。
第二,GPU batch 不是固定不变的请求列表。在 A 继续生成的时候,B 可能刚好完成,而 C 可能刚刚加入。EngineCore 每一轮都要重新决定计算哪些 token,而不是在服务启动时就确定一个永久不变的 batch。
后面 18.2 会继续看 EngineCore 与 Request 的具体数据结构,18.3 再沿着 Scheduler.schedule() 分析这些请求如何进入 GPU。
18.1.6 运行一个真正的 vLLM Server
我们已经看到服务的三个层次,下面用一个简单实验把它们连起来。先在终端启动服务:
vllm serve Qwen/Qwen3-0.6B \
    --max-model-len 2048 \
    --default-chat-template-kwargs '{"enable_thinking": false}'
实际运行前,需要安装与 CUDA、PyTorch 和硬件环境相匹配的 vLLM,以及客户端所需的 openai Python 包。vLLM 服务默认使用本地 8000 端口。我们在另一个终端或者 notebook 中使用 OpenAI Python client 发送请求。这里选择 chat completions,是因为我们要验证请求可以正确经过 chat template,再进入 Engine,而不是手动拼接模型的特殊 token。
model = 'Qwen/Qwen3-0.6B'
client = oai.OpenAI(base_url='http://127.0.0.1:8000/v1', api_key='EMPTY')

response = client.chat.completions.create(
    model=model,
    messages=[
        {
            'role': 'user',
            'content': 'What should I build first in Minecraft survival mode? '
            'Explain in one paragraph.',
        },
    ],
    temperature=0.7,
    max_tokens=128,
)

print(response.choices[0].message.content)
In Minecraft survival mode, it's best to start by building a stable and safe foundation, such as a shelter or a small village, to ensure you can survive and grow over time. This allows you to focus on crafting tools, building structures, and exploring the environment without being overwhelmed by the initial challenges of survival.这段代码与调用其他兼容 OpenAI API 的服务几乎没有区别。但实际执行时,create() 并没有直接调用 GPU 上的 PyTorch 模型。它先通过 HTTP 到达 vLLM 的 API server,再进入 EngineCore 的调度与模型执行流程。我们在客户端看到的是最终返回的文本,而 EngineCore 则在内部维护请求状态、KV cache 和调度逻辑。
接下来,我们尝试同时发送多个请求。
client = oai.AsyncOpenAI(base_url='http://127.0.0.1:8000/v1', api_key='EMPTY')
model = 'Qwen/Qwen3-0.6B'


async def generate(prompt: str) -> str:
    response = await client.chat.completions.create(
        model=model,
        messages=[{'role': 'user', 'content': prompt}],
        temperature=0.7,
        max_tokens=128,
    )
    return response.choices[0].message.content or ''


prompts = [
    'What should I build first in Minecraft survival mode?',
    'How can I survive my first night in Minecraft?',
    'How do I defeat the Ender Dragon in Minecraft?',
]
prompts = [p + ' Explain in one paragraph.' for p in prompts]
responses = await asyncio.gather(*(generate(p) for p in prompts))

for i, response in enumerate(responses, start=1):
    print(f'Request {i}: {response}\n')
Response 1: In Minecraft survival mode, it's best to start by building a shelter or a safe area to protect yourself from the elements, then focus on farming or gathering materials to support your survival, and finally complete your main objectives, such as building a home or a structure.
Response 2: Surviving your first night in Minecraft involves staying alert, exploring your surroundings, and avoiding the risk of getting lost. Make sure to check your map regularly, avoid exploring too far, and use the in-game tools like the Nether portal or crafting materials to stay safe. Stay positive and keep moving to avoid getting stuck.
Response 3: To defeat Ender Dragon in Minecraft, you need to use the Ender Dragon's armor, which is a powerful item that grants you immunity to most types of damage. Once you have the armor, you can attack the dragon from behind, using items like TNT to create a firestorm and then strike with the Ender Dragon's sword. After defeating the dragon, you can collect its bones and use them to build stronger weapons or craft your own weapons for future battles.这里使用 asyncio.gather() 让客户端并发发出三个请求,而不是等待第一个请求完成后再发送第二个。需要注意,并发发送不等于证明它们一定在同一轮 GPU batch 中执行。实际调度结果取决于请求到达时间、当前负载、token budget 和可用 KV cache 等条件。我们现在只需要观察到三个请求都可以被服务接收,并且各自得到独立的结果。
在服务端的统计日志中,一些版本和配置还会报告 running、waiting 请求数和 token throughput 等信息。你可以对照并发请求观察日志的变化。后面我们会通过更具体的状态与源码分析来验证。
18.1.7 从使用接口到阅读源码
如果我们只想使用 vLLM,理解 LLM、vllm serve 和客户端调用就已经足够。但如果想知道为什么它能够管理多个请求,就必须进入内部实现。下面是这一章最重要的源码入口:
| 组件 | 常见源码位置 | 负责什么 |
|---|---|---|
| Offline 入口 | vllm/entrypoints/llm.py |
LLM 的用户接口 |
| Online 入口 | vllm/entrypoints/ |
HTTP server 与 API 路由等入口逻辑 |
| Engine Frontend | vllm/v1/engine/ |
输入处理、EngineCoreClient 和输出处理 |
| EngineCore | vllm/v1/engine/core.py |
运行调度与执行循环 |
| Scheduler | vllm/v1/core/sched/scheduler.py |
决定本轮执行哪些 token |
| KV cache | vllm/v1/core/kv_cache_manager.py |
管理 KV cache block |
| GPU worker | vllm/v1/worker/gpu_worker.py |
初始化和管理 GPU 执行资源 |
| Model Runner | vllm/v1/worker/gpu_model_runner.py |
准备输入并执行模型 |
这些是定位源码的入口,不代表所有实现都只在对应的单个文件中。尤其是 API server、attention backend 和并行执行相关代码,通常还会涉及其他模块。随着版本变化,具体路径与内部类名也可能调整。
这一节我们先不逐行分析这些文件。我们需要先建立一个清楚的对应关系:LLM 和 API server 面向用户,EngineCore 负责管理请求与调度,KVCacheManager 负责分配和回收缓存,GPU worker / Model Runner 负责执行 GPU 计算。理解了这条主线,后面进入某个函数时,就能知道它在整个系统中处于什么位置,而不是只看到一连串相互调用的 Python 类。
18.1.8 本章小结
从用户的角度看,vLLM 仍然是在完成文本生成:给定 prompt,返回新的 token。但从引擎内部看,最重要的变化是:
生成不再只是一个独立的函数调用,而是一组需要持续调度、执行和管理状态的请求。
在 vLLM V1 中,我们可以把主要执行路径记成:
\[ \mathrm{Input}\rightarrow\mathrm{EngineCore}\rightarrow\mathrm{Scheduler} \rightarrow\mathrm{Worker}\rightarrow\mathrm{Output} \]
其中,API server 和 offline inference 是不同的使用入口。EngineCore 与 Scheduler 决定应该如何使用 GPU,worker 则负责真正的模型执行。接下来的 18.2,我们从 EngineCore 和 Request 入手,看看一个请求进入引擎以后,究竟以什么形式存在,又是怎样被推进到下一轮计算的。
References
Kwon, Woosuk, Zhuohan Li, Siyuan Zhuang, et al. 2023. Efficient Memory Management for Large Language Model Serving with PagedAttention. https://arxiv.org/abs/2309.06180.